Omniroute : passerelle d'IA multi-modèles à faible latence avec cache sémantique.
Conception d'une passerelle d'inférence sous 15ms normalisant les requêtes OpenAI et Anthropic avec supervision temps réel, cache sémantique Redis et routage dynamique.
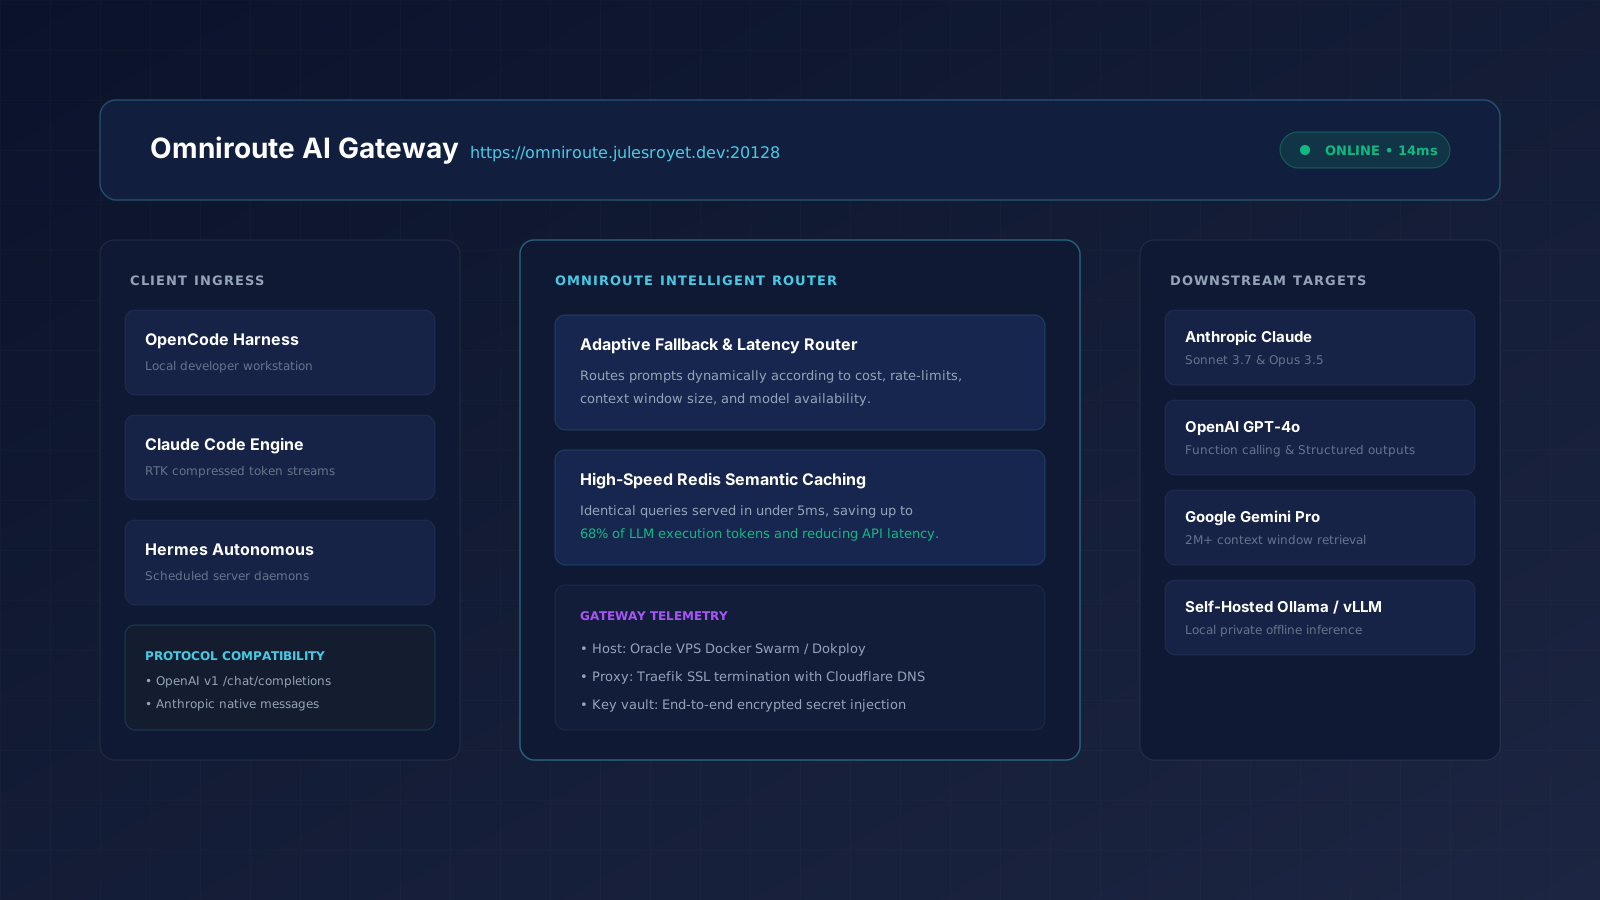
La problématique : éliminer les pannes de fournisseurs et les requêtes redondantes.
Les applications connectées directement aux APIs d'IA subissent des pics de latence, des dépassements de quotas et des divergences de schémas. Omniroute a été conçu comme une couche d'entrée unifiée qui normalise les payloads, met en cache les prompts identiques ou sémantiquement proches dans Redis et bascule automatiquement sur un modèle secondaire en cas de dépassement de seuil.
Architecture streaming edge.
Les requêtes arrivent via le réseau Cloudflare avec terminaison SSL et limitation de débit. Un proxy de streaming Node.js analyse les flux de tokens morceau par morceau sans allocation de tampon intermédiaire, mesurant en temps réel le TTFT (Time to First Token) et indexant les hashs vectoriels dans Redis.
Défis techniques clés.
- Maintien de l'intégrité du streaming SSE (Server-Sent Events) tout en calculant la consommation de tokens au fil de l'eau.
- Stratégies d'invalidation du cache sémantique selon la température et l'aléa des requêtes.